文本相似度比较API【杭州数脉】【数脉科技】

- API介绍
- API渠道
- API接口
- 定价


什么是文本相似度比较?
基于当前市场需求,文本相似度比较API服务应运而生。这类API服务利用全网海量数据和先进的深度神经网络技术,为用户提供高精度的文本相似度比较服务。通过分析语义相似度,这些API能够帮助用户快速实现推荐、检索和排序等应用。
文本相似度比较API的核心功能在于分析两个文本之间的语义相似程度。这些API借助先进的算法,如基于余弦相似度的文本向量计算等,可以准确评估文本之间的相似度。其优势在于提供高效、快速的搜索与替换语义功能,同时能够帮助用户进行文本排序,更好地表达句意。
企业可以通过接入文本相似度比较API,提升其搜索引擎的准确性,并降低人工识别成本。这类API不仅可以用于电商购物平台,帮助消费者快速获得答案,还可以应用于搜索引擎平台,帮助用户解决描述问题的困难。通过短文本相似度比较API,用户可以更加便捷地获取相关信息,提升了用户体验,也为企业节约了成本,实现了双赢局面。
本相似度比较API服务的出现,为用户提供了一种高效、准确的文本相似度比较解决方案,助力用户实现多种文本处理任务,提升了搜索引擎的准确性,降低了企业的人工成本。
文本相似度比较有哪些核心功能?
1. 短文本相似度计算
- 语义深度分析:不同于简单的字符串匹配或关键词比对,短文本相似度计算能够深入到文本的语义层面,理解文本背后的含义和上下文。这通常依赖于自然语言处理(NLP)技术,如词嵌入(Word Embeddings)、BERT等预训练语言模型,它们能够捕捉词汇之间的语义关系。
- 量化评估:通过计算得到的相似度值(通常是0到1之间的实数),可以直观地反映两个短文本之间的相似程度。这个值不仅便于人类理解,也便于机器处理,为后续的数据分析、决策制定等提供基础。
- 应用场景广泛:短文本相似度计算在信息检索、内容推荐、抄袭检测、问答系统等多个领域都有重要应用。例如,在搜索引擎中,通过计算用户查询与网页内容的相似度,可以返回更相关的结果;在内容推荐系统中,则可以根据用户的历史行为推荐相似的内容。
2. 短文本相似聚合
- 信息去冗:在大量短文本数据中,往往存在内容相近或重复的文本。通过短文本相似聚合功能,可以自动识别和归类这些文本,减少信息的冗余,提高信息处理的效率。
- 内容精简:聚合后的文本集合更加紧凑,便于用户快速浏览和理解。在新闻聚合、社交媒体内容整理等场景中,这有助于提升用户体验。
- 优化决策制定:在电商、科研等领域,短文本相似聚合可以帮助决策者快速了解市场趋势、研究热点等信息,从而做出更加明智的决策。
- 自动化处理:该功能通常能够自动化运行,无需人工干预,大大提高了处理大量文本数据的效率。
文本相似度比较的技术原理是什么?
- 文本表示:
- 分词:首先,将待比较的文本进行分词处理,即将文本切分为一系列有意义的词语或词组。
- 向量化:然后,利用词袋模型(Bag of Words)、TF-IDF(Term Frequency-Inverse Document Frequency)模型、词嵌入(Word Embeddings)等方法,将文本转换为高维向量空间中的点(即文本的数值化表示)。其中,词嵌入方法如Word2Vec、GloVe等,能够更好地捕捉词语之间的语义关系。
- 相似度计算:
- 在文本被表示为向量后,可以通过计算向量之间的距离或相似度来评估文本之间的相似程度。常用的相似度度量方法包括余弦相似度(Cosine Similarity)、欧氏距离(Euclidean Distance)、曼哈顿距离(Manhattan Distance)等。
- 余弦相似度是通过计算两个向量在夹角上的余弦值来评估它们的相似度,值越接近1表示越相似;而欧氏距离和曼哈顿距离则是通过计算两个向量在空间中的直线距离来评估它们的差异,距离越小表示越相似。
文本相似度比较的核心优势是什么?
 |
 |
 |
|
标准API接口 |
服务商账号统一管理 |
零代码集成服务商 |
 |
 |
 |
|
智能路由
|
服务扩展 服务扩展不仅提供特性配置和归属地查询等增值服务,还能根据用户需求灵活定制解决方案,满足多样化的业务场景,进一步提升用户体验和满意度。
|
可视化监控 |
在哪些场景会用到文本相似度比较?
1. 信息检索
在信息检索领域,"文本相似度比较"API接口的应用极为广泛且深入。它不仅能够处理传统的纯文本检索任务,帮助用户从海量数据中快速找到与查询文本相似的内容,提升检索的准确性和效率;还能够跨越媒体界限,结合标签、元数据等信息,实现对图片、视频等非文本内容的相似度检索。例如,在图像搜索引擎中,通过提取图片中的文本描述或标签,利用文本相似度算法,可以为用户推荐视觉上相似或主题相关的图片;在视频平台,则可以基于视频标题、简介或自动生成的字幕进行相似视频推荐,满足用户多样化的信息需求。
2. 新闻推荐
新闻推荐系统是"文本相似度比较"API接口的又一重要应用场景。随着新闻媒体的快速发展,用户每天面对的信息量呈爆炸式增长。为了提升用户体验,新闻推荐系统会根据用户的历史浏览记录,特别是用户刚刚浏览的新闻标题,利用文本相似度算法快速检索出与之相似的其他新闻,并个性化地推送给用户。这样不仅能够帮助用户发现更多感兴趣的内容,还能有效缓解信息过载问题,提升新闻阅读的针对性和满意度。
3. 智能客服
在智能客服领域,"文本相似度比较"API接口同样扮演着关键角色。当用户输入一个问题时,智能客服系统首先会利用文本相似度算法在已有的问题库中寻找与之相似的问题及其答案。如果找到高度相似的问题,系统便能迅速给出相应的答案,实现快速响应;如果没有找到完全匹配的问题,系统还可以根据相似度排序,提供可能相关的答案或引导用户进一步描述问题。这种方式不仅提高了客服响应的速度和准确性,还减轻了人工客服的负担,提升了用户满意度和企业的服务效率。此外,随着对话的深入,系统还能不断学习和优化,提升对用户意图的理解能力,提供更加精准和个性化的服务。
4. 学术论文查重
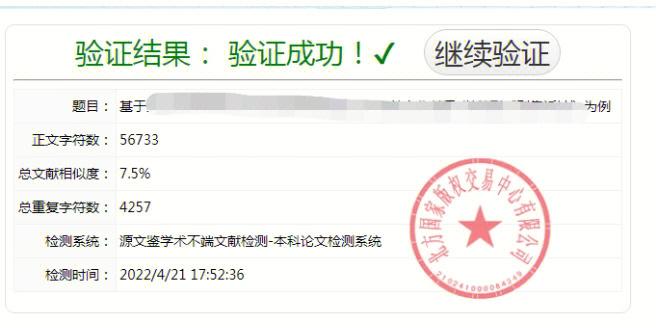
在学术研究和出版领域,"文本相似度比较"API接口是防止学术不端行为(如抄袭、剽窃)的重要工具。当学者或出版商提交学术论文时,系统可以自动运行文本相似度比较算法,将待检查的论文与数据库中的已有文献进行比对。这不仅能够识别出直接的文本复制,还能捕捉到经过改写但仍保留原意的相似段落。通过设定合适的相似度阈值,系统能够辅助评审人员快速筛选出可能存在抄袭嫌疑的论文,从而维护学术界的诚信和研究的原创性。
什么是文本相似度比较API?
文本相似度比较API通过语义分析技术,计算两段文本之间的相似度得分。这一解决方案适用于文本比对、内容审核及相同内容检测,无论是自然语言处理、机器翻译还是信息检索领域,都能提供高效的支持。
文本相似度比较API的核心功能有哪些?
高精度相似度计算
利用语义分析算法,精准评估两文本相似程度,为用户提供明确的相似度得分,助力相关应用的性能提升。
多语言支持
不仅支持中文文本,还能处理多种语言,扩展了API的适用范围,为全球用户提供便利。
实时响应
高效的计算能力确保API能够及时返回相似度得分,支持实时应用需求,提升用户体验。
灵活集成
API设计简洁易用,可无缝集成入各种系统,使开发者能够快速应用此功能提升项目的智能化程度。
文本相似度比较API的技术原理是什么?
文本相似度比较有哪些应用场景?
为什么要进行文本相似度比较API试用?
文本相似度计算的精度可能因应用场景不同而存在差异,试用可以帮助您确认此API是否满足特定业务需求。
通过试用文本相似度API,您可以直观感受调用流程及文档质量,判断集成的简易程度。
试用文本相似度API提前发现调用次数或语言支持等限制,确保后续使用不受影响。
通过试用API来测试其稳定性和响应速度,降低正式集成时出现技术障碍的风险。
为什么要集成通用API
标准API接口
我们提供标准的API接口和详细的接入文档,帮助用户快速、便捷地将服务集成到自己的应用程序中。接入流程简单明了,无需复杂的配置和调试即可实现快速接入。
零代码集成服务商
通过一套改进过的流程来实现研发过程的零采购、零干扰。让程序员优先对接API服务,匹配业务需求,验证项目可行性上线之后再启动采购,24小时内即可上线运行
智能路由
采用智能路由规则,动态分配识别通道,有效提升了验证的准确率,其性能高于同行业平台,通过不断优化算法和模型,确保精准度和准确性
服务扩展
服务扩展不仅提供文本相似度比较API的特性配置与增值服务,还能根据用户需求灵活定制解决方案,满足多样化的业务场景,进一步提升用户体验和满意度。
| 参数名 | 参数类型 | 默认值 | 是否必传 | 描述 |
|---|---|---|---|---|
| text1 | string | 是 | ||
| text2 | string | 是 | ||
| lang | string | 是 | 支持的文本语言类型,默认为“zh” |
| 参数名 | 参数类型 | 默认值 | 描述 |
|---|---|---|---|
| similarity | number |
| 错误码 | 错误信息 | 描述 |
|---|---|---|
| FP00000 | SUCCESS | |
| FP03333 | FAILURE |
请求参数{
    "text1": "",
    "text2": "",
    "lang": ""
}

返回参数
{
    "similarity": ""
}

错误码
{
    "FP00000": "SUCCESS",
    "FP03333": "FAILURE"
}